소리와 대사가 생긴 AI 월드 모델, 구글 딥마인드 Genie 4 쉽게 정리
2026년 10월 27일(미국 현지 기준) 발표된 구글 딥마인드의 월드 모델 Genie 4를 쉽게 풀었습니다. Genie 2·3과 무엇이 다른지, 지금 쓸 수 있는지, 아직 못 하는 건 무엇인지 공식 자료와 언론 보도 기준으로 정리했습니다.
글로 장면을 적어 넣으면 그 안을 키보드로 돌아다닐 수 있는 가상 세계가 열립니다. 주변에서는 바람 소리가 나고, 곁에 선 인물은 내 행동에 말로 반응합니다. 2026년 10월 27일(미국 현지 기준) 구글 딥마인드가 발표한 월드 모델 Genie 4가 보여 주는 장면입니다. 영상처럼 보이지만 다른 점이 하나 있습니다. 보는 사람이 움직이는 대로 다음 장면이 그때그때 새로 그려진다는 것입니다.
다만 아무나 지금 써 볼 수 있는 서비스는 아닙니다. 이 글은 10월 28일 기준 DeepMind 공식 발표문과 언론 보도에서 확인되는 내용만 담았고, 공식 자료에 없는 숫자는 "공식 자료에 명시 없음"으로 적었습니다.
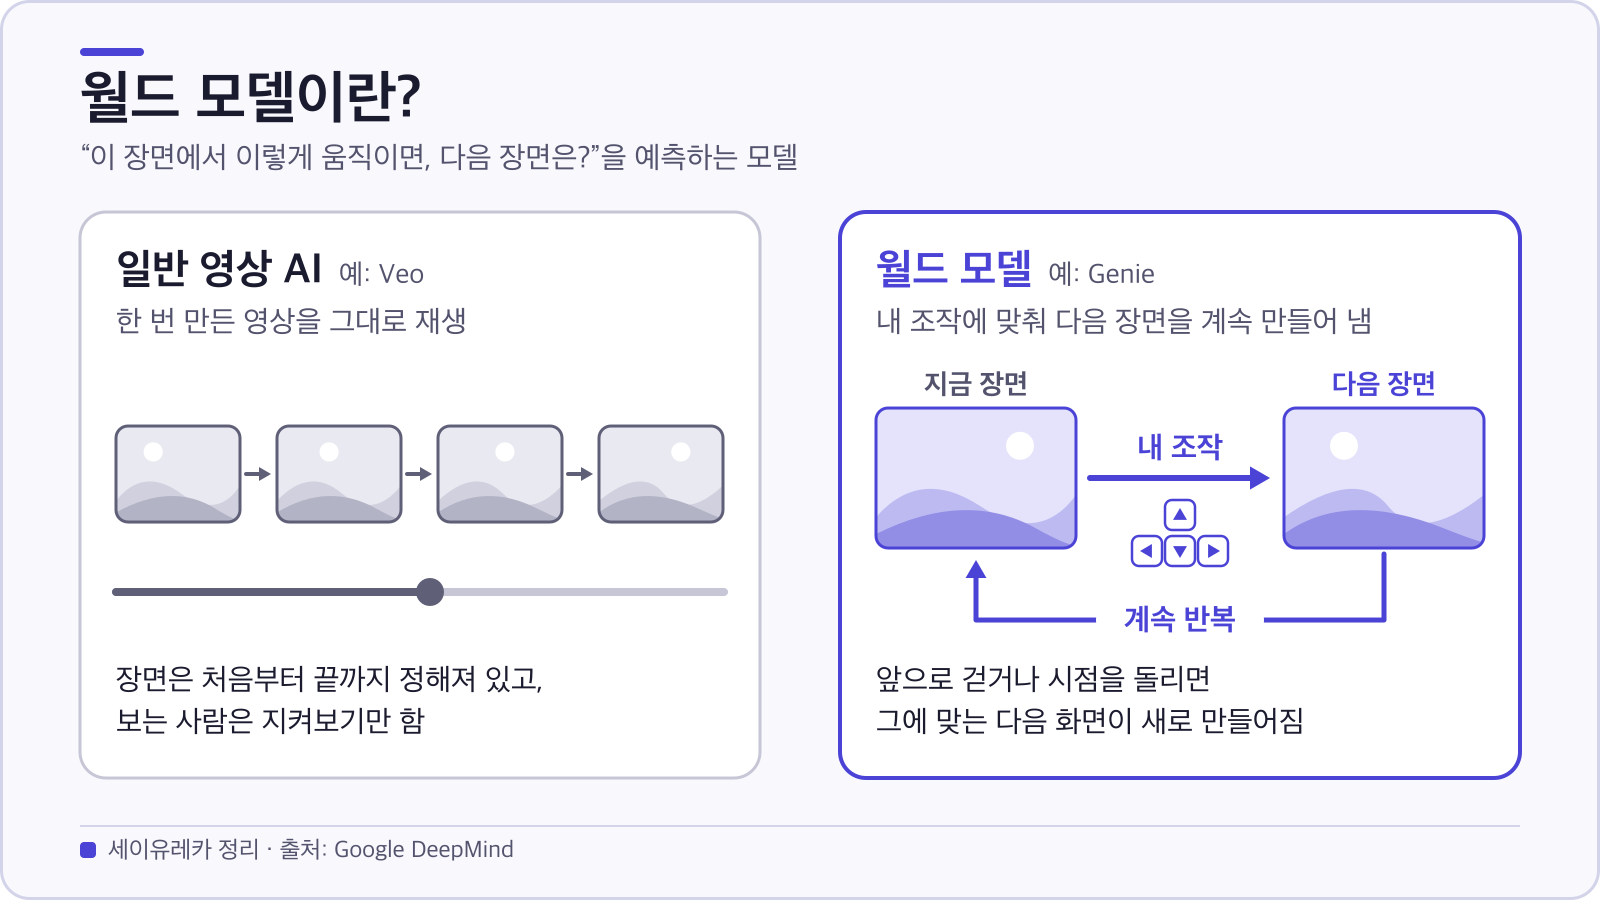
그림: 일반 영상 AI와 월드 모델의 차이 — 세이유레카 정리 (출처: Google DeepMind 공식 발표)
한 줄 요약
- Genie 4는 글로 시작해 키보드로 돌아다니는 세계를 만들고, 글(자연어 입력)로 날씨나 인물을 바꿀 수 있는 월드 모델입니다. 새로 들어온 대표 기능은 소리와 인물의 대사를 세계와 함께 만든다는 점입니다.
- 지금은 "신뢰할 수 있는 테스터" 대상 연구 미리보기입니다. Google AI Ultra 구독자와 개발자 API 초기 파트너에게 "곧" 열린다고 하지만 가격, 지역, 날짜는 현재 확인된 공식 자료에는 없습니다.
- 해상도와 초당 프레임 수는 공식 발표에 없고, 이어 갈 수 있는 시간은 "몇 분" 수준이라고만 했습니다. 길어지면 장면이 흔들린다는 점도 DeepMind가 직접 밝혔습니다.
월드 모델이 뭔가요?
눈을 감고 컵을 식탁 모서리에 걸쳐 놓는 장면을 떠올려 보세요. 건드리면 떨어질 거라는 걸 실제로 해 보지 않아도 압니다. 머릿속에서 결과를 미리 돌려 본 것입니다. 월드 모델은 AI에게 이런 머릿속 시뮬레이터를 만들어 주려는 기술입니다. "이 장면에서 이렇게 움직이면 다음 장면은 어떻게 될까"를 예측하는 모델이라고 보시면 됩니다.
롤플레잉 보드게임의 진행자(게임 마스터)에 비유할 수도 있습니다. 플레이어가 "문을 열겠다"고 하면 진행자가 문 너머의 풍경을 설명해 줍니다. Genie는 그 일을 말 대신 화면으로 합니다. 앞으로 걷거나 시점을 돌리면 그에 맞는 다음 화면이 만들어집니다.
전통적인 게임은 대개 사람이 미리 만든 지도를 불러오지만, Genie 3 발표문에 따르면 Genie의 세계는 세계 설명과 사용자의 행동을 바탕으로 프레임마다 그때그때 만들어집니다. 시리즈의 걸음은 이렇습니다. DeepMind에 따르면 Genie 1은 2D 세계를 만들었고, 2024년 12월 Genie 2에서 3D 환경으로 넓어졌고, 2025년 8월 Genie 3에서 DeepMind 자사 첫 실시간 상호작용 월드 모델이 나왔습니다. 연구자들이 이런 모델에 기대하는 건 로봇이나 AI 에이전트가 연습할 수 있는 끝없이 바뀌는 가상 세계입니다.
Genie 4는 무엇이 달라졌나
DeepMind는 네 가지가 나아졌다고 설명합니다. 실시간 조종, 물리와 인물 표현, 소리, Gemini 모델과의 결합입니다.
소리와 대사가 생겼다
Genie 4는 음악, 주변 소리, 인물의 대사를 세계와 동시에 만들어 냅니다. DeepMind는 이를 자사 실시간 월드 모델 가운데 소리를 직접 만든 첫 사례라고 소개합니다. 나무 사이의 바람, 해변의 파도처럼 세계마다 자기 환경에 맞는 소리가 깔리고, 인물은 내 입력이나 세계의 사건에 따라 즉석에서 말을 주고받습니다.
인물과 물리가 더 사실적이다
DeepMind가 가장 극적인 도약으로 꼽은 건 사람 표현입니다. 인물이 자연스럽게 움직이고, 환경에 반응하고, 실시간으로 조종됩니다. 공기 흐름이나 충돌 같은 물리 상황도 더 사실적으로 그린다고 합니다. 모두 DeepMind의 설명이고, 제가 확인한 범위에서는 독립적으로 검증된 결과를 찾지 못했습니다.
글로 세계를 바꾼다
이동과 카메라는 키보드와 마우스로, 장면 변경은 글로 합니다. 날씨를 바꾸고, 카메라를 옮기고, 새로운 사람이나 물건을 불러올 수 있습니다.
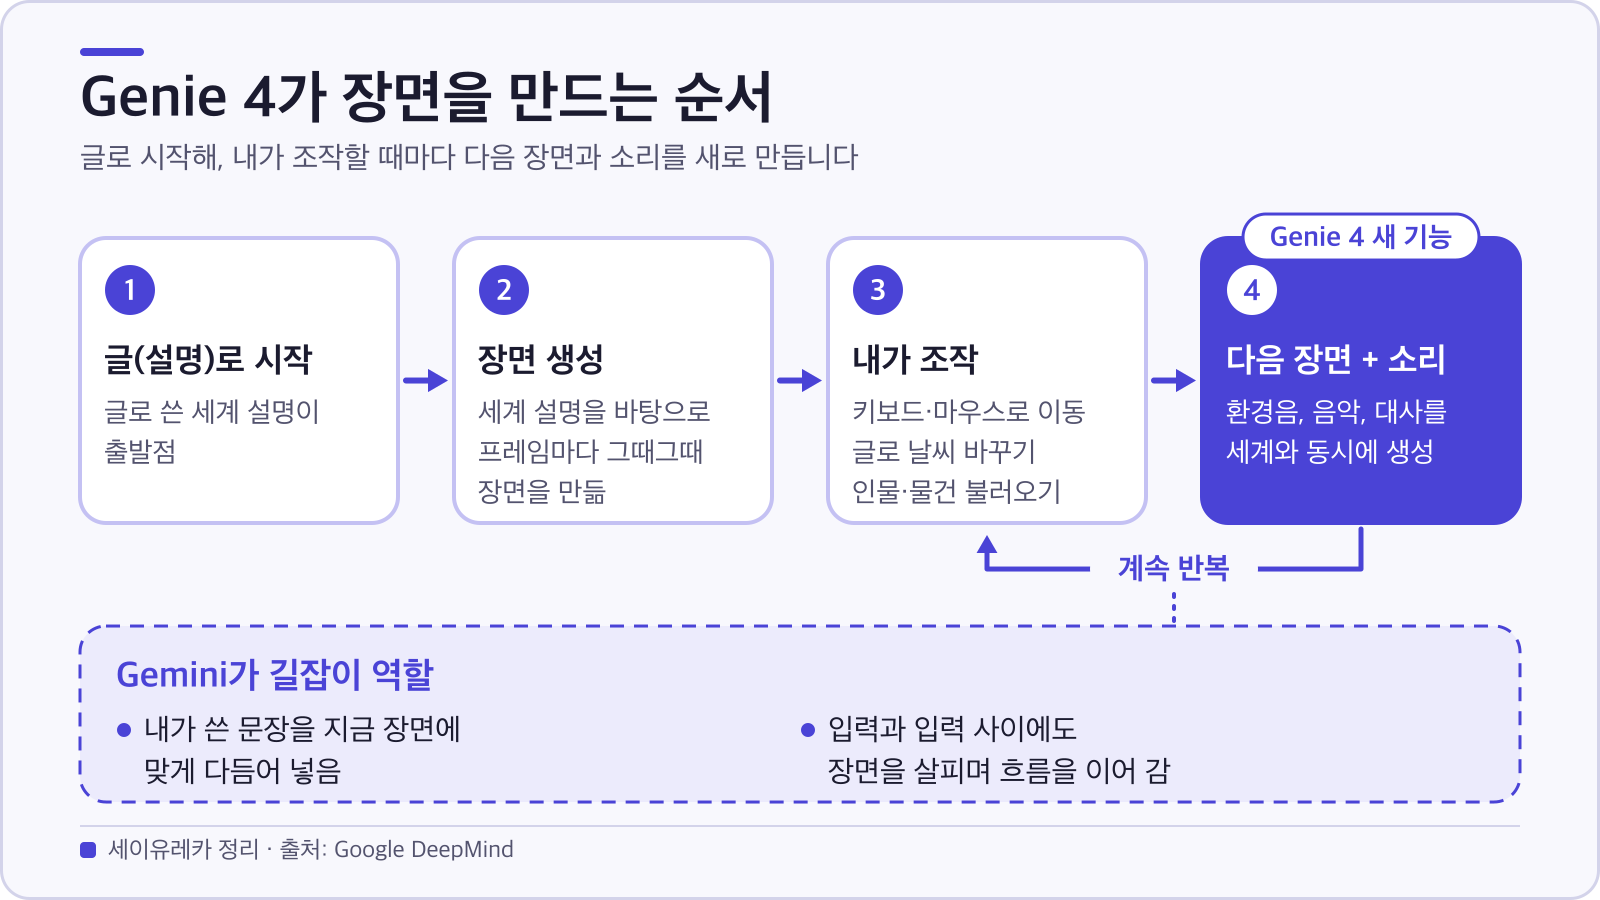
그림: Genie 4가 장면을 만드는 순서 — 세이유레카 정리 (출처: Google DeepMind 공식 발표)
짚어 둘 점이 있습니다. 날씨 변경이나 물체·인물 추가는 Genie 3에도 "월드 이벤트"라는 이름으로 있었습니다. Genie 4에서 새로 설명된 건 Gemini가 내 문장을 지금 장면에 맞게 다듬어 넣고, 내가 입력하지 않는 사이에도 장면을 살피며 흐름을 이어 간다는 부분입니다.
Gemini가 길잡이 역할을 한다
DeepMind에 따르면 Gemini Omni는 세계가 현실의 모습과 행동에 가깝도록 기준을 잡고, 다른 Gemini 모델들은 장면이 앞뒤가 맞게 이어지도록 추론합니다. 복잡한 사건을 다룰 때는 Gemini 3.8 Flash가 길잡이로 함께 돌아갑니다. 큰 목표를 작은 단계로 나눠 두고, 화면이 만들어지는 대로 그 단계가 잘 지켜지는지 지켜보다가, 사용자가 끼어들거나 상황이 달라지면 계획을 바꿔 줍니다. 배우가 연기하는 동안 연출자가 옆에서 지시를 바꾸는 모습에 비유할 수 있습니다. 이 비유는 제가 붙인 것입니다.
연구 실험도 소개됐습니다. Gemini 4 Argon이 과제를 단계로 나눠 글자 설명으로 넘기면 Genie 4가 그 단계를 화면으로 그립니다. 예시는 Apptronik의 휴머노이드 로봇 Apollo가 체커를 두는 장면인데, 실제 로봇이 아니라 가상 세계 안의 시뮬레이션입니다.
얼마나 오래 이어질까
가장 헷갈리는 부분입니다. DeepMind 발표문에는 시간이 숫자로 나와 있지 않고, 공식 모델 페이지의 한계 항목에 몇 분 수준의 연속 상호작용을 지원한다고 적혀 있을 뿐입니다. 테크크런치는 장면을 최대 2분까지 일관되게 유지하고 이는 이전 버전 한계의 두 배라고 보도했지만, 이 숫자는 DeepMind 글에서 찾지 못했습니다. Genie 3의 공식 표현은 몇 분이고, Genie 3 기반 시험 서비스(Project Genie)는 생성 길이를 60초로 제한했습니다. 기준이 달라 곧바로 비교하기는 어렵습니다.
한눈에 비교: Genie 2 · 3 · 4
공식 자료 기준이며, 언론 보도 수치는 따로 표시했습니다. 공식 글에 없는 칸은 그렇게 적었습니다.
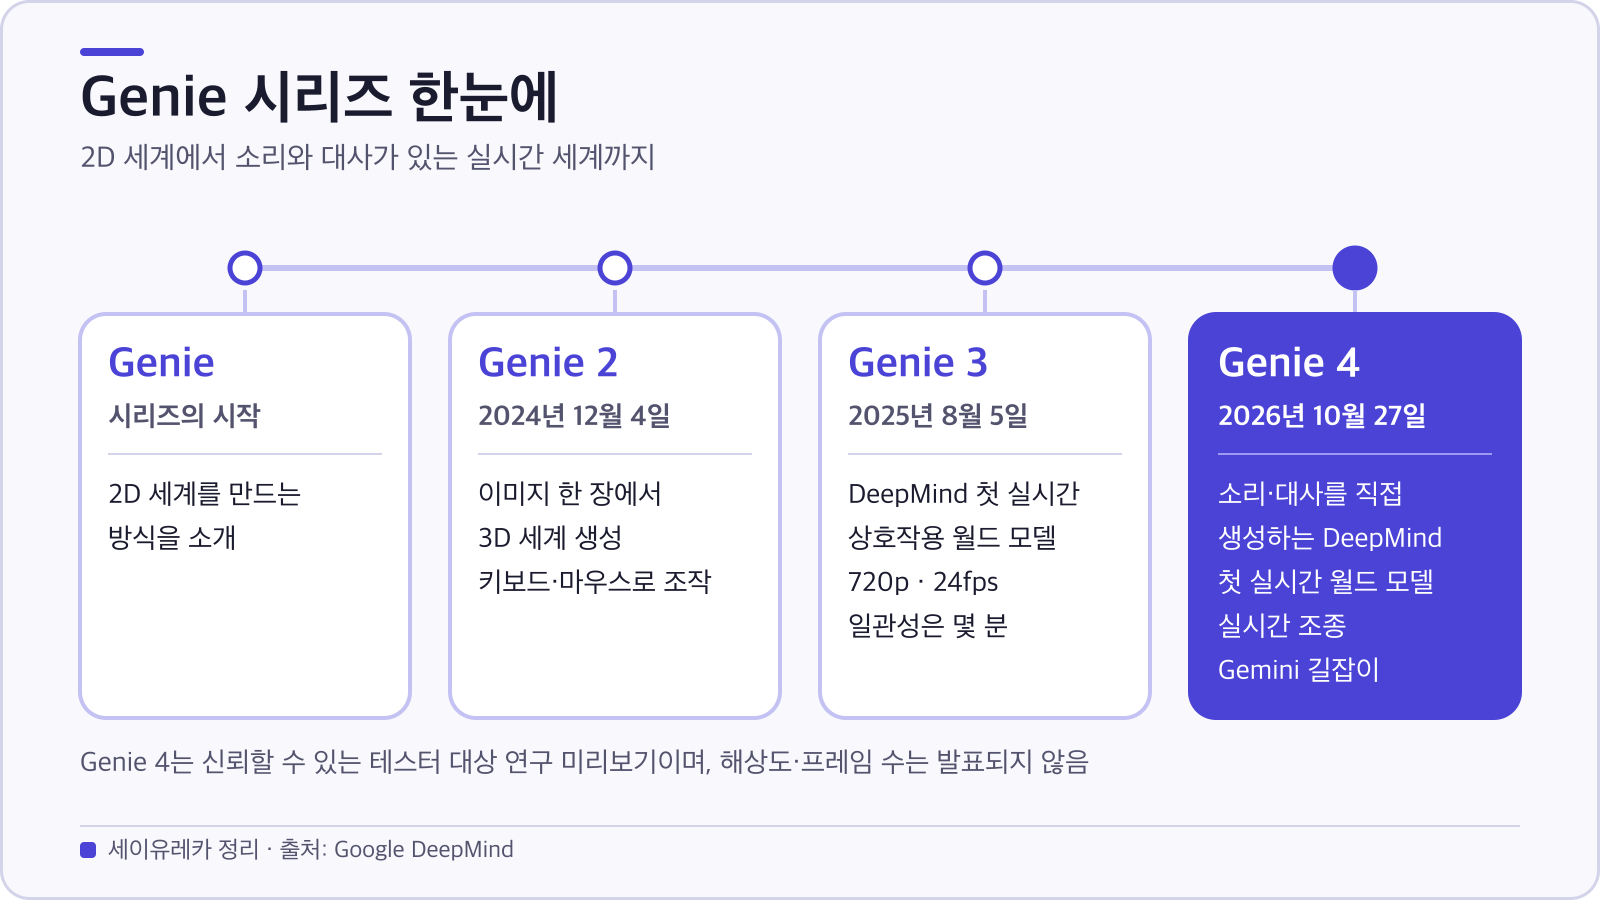
그림: Genie 시리즈 연표 — 세이유레카 정리 (출처: Google DeepMind 공식 발표)
| 항목 | Genie 2 | Genie 3 | Genie 4 |
|---|---|---|---|
| 발표일 | 2024년 12월 4일 | 2025년 8월 5일 | 2026년 10월 27일 |
| 시작점 | 이미지 한 장 | 글로 쓴 세계 설명 | 글로 쓴 설명(데모에는 참고 이미지도 사용) |
| 조작 | 키보드·마우스 | 이동 입력 + 글로 일으키는 월드 이벤트 | 키보드·마우스 + 글로 장면 바꾸기(Gemini가 장면에 맞게 조정) |
| 실시간 상호작용 | 공개 영상은 경량화 전 모델 결과, 경량화 버전은 화질을 낮춰 실시간 가능 | 실시간 (DeepMind 자사 첫 실시간 상호작용 월드 모델) | 실시간 |
| 해상도 | 공식 자료에 명시 없음 | 720p | 공식 자료에 명시 없음 |
| 초당 프레임 | 공식 자료에 명시 없음 | 24프레임 | 공식 자료에 명시 없음 |
| 이어 갈 수 있는 시간 | 일관된 세계 최대 1분(공개 예시 대부분 10~20초) | 일관성 "몇 분", 시각 기억은 약 1분 전까지 | "몇 분"의 연속 상호작용(수치는 공식 자료에 명시 없음, 테크크런치는 최대 2분 보도) |
| 소리·대사 | 공식 글에 언급 없음 | 공식 글에 언급 없음 (Genie 4 글이 "소리를 직접 생성하는 첫 실시간 월드 모델"이라 소개) | 환경음·음악·인물 대사를 함께 생성 |
| Gemini 결합 | 공식 글에 언급 없음 | 공식 글에 언급 없음 | Gemini Omni 등 Gemini 모델과 결합 |
| 접근 | 공식 글에 접근 방법 언급 없음 | 소규모 학계·창작자 대상 제한적 연구 미리보기 | 신뢰할 수 있는 테스터 대상 연구 미리보기, 곧 AI Ultra·API 초기 파트너 |
주석: Genie 3 발표문에는 소리 기능이 따로 언급되지 않습니다. 다만 Genie 4 발표문이 자신을 소리를 직접 만든 첫 실시간 월드 모델로 소개하고 있어 함께 적었습니다.
어디에 쓰일까
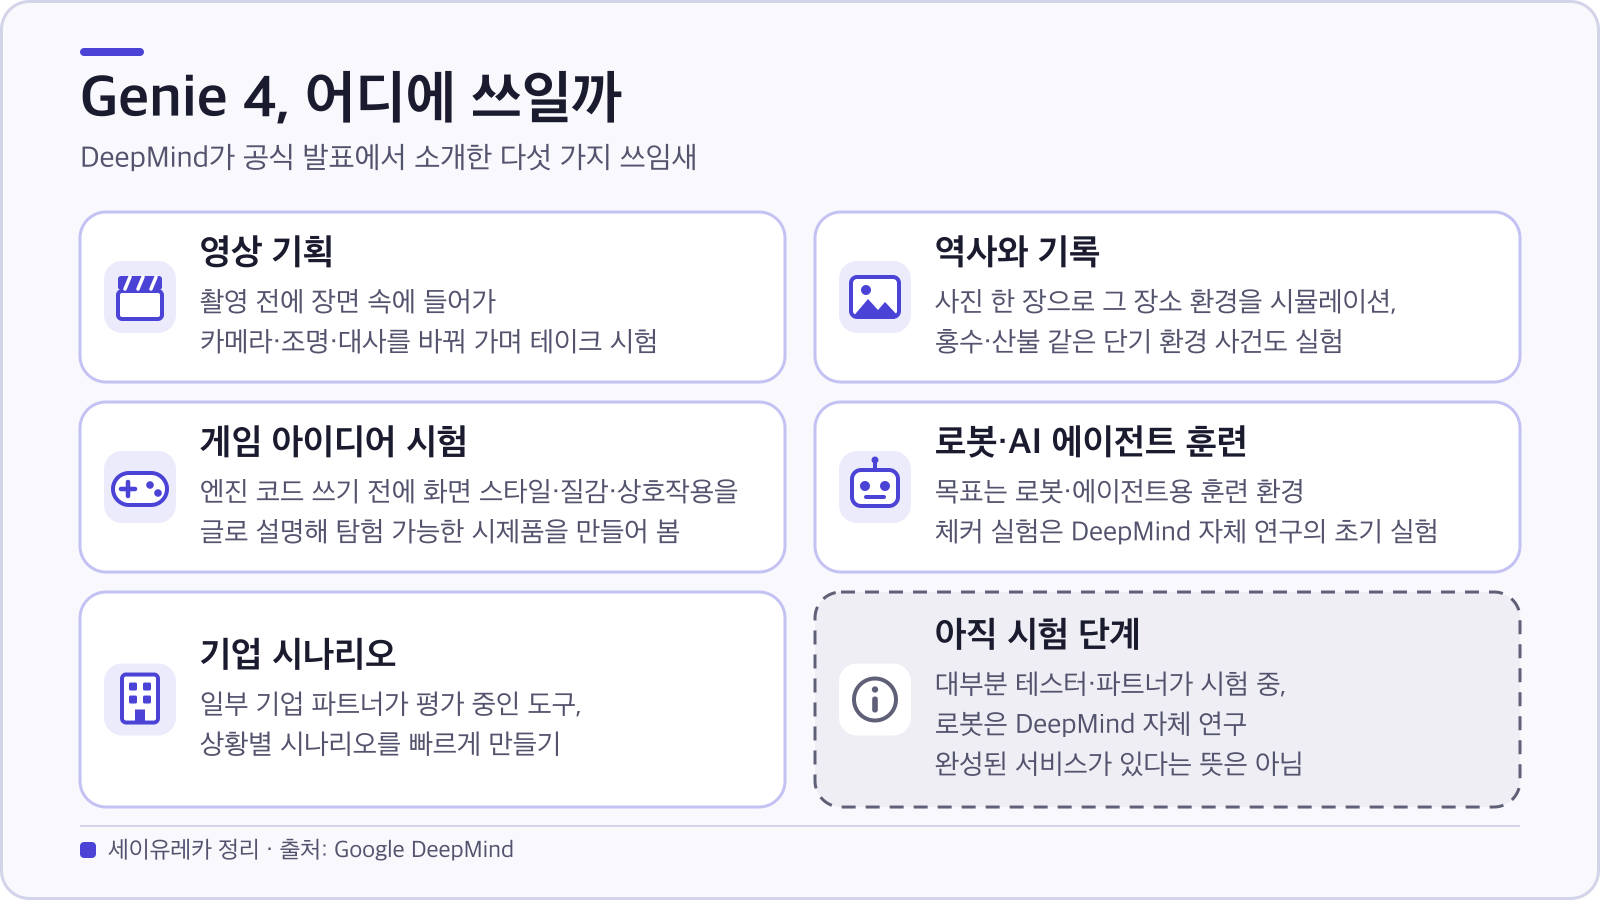
그림: DeepMind가 소개한 Genie 4 쓰임새 — 세이유레카 정리 (출처: Google DeepMind 공식 발표)
DeepMind가 소개한 쓰임새입니다. 대부분 테스터·파트너가 시험하는 단계이고, 로봇 항목은 DeepMind 자체 연구 실험입니다. 완성된 서비스가 있다는 뜻은 아닙니다.
- 영상 기획: 촬영 전에 장면 속에 들어가 카메라 각도, 조명, 대사, 행동을 바꿔 가며 여러 번 테이크를 돌려 보는 드래프트 용도입니다.
- 역사와 기록: 보관된 사진 한 장으로 그 장소의 환경을 시뮬레이션하거나, 홍수나 산불 같은 단기 환경 사건이 전개되는 모습을 보는 실험입니다.
- 게임 아이디어 시험: 엔진 코드를 쓰기 전에 화면 스타일, 질감, 상호작용 방식을 글로 설명해 탐험 가능한 시제품을 만들어 봅니다.
- 로봇·AI 에이전트 훈련: 위의 체커 실험은 그 방향의 초기 실험이고, DeepMind의 목표는 로봇·에이전트용 훈련 환경입니다. DeepMind는 이를 로봇 시뮬레이션을 위한 무한한 놀이터라고 표현했습니다.
- 기업 시나리오: 일부 기업 파트너가 상황별 시나리오를 빠르게 만드는 도구로 평가 중이라고 합니다.
지금 써볼 수 있나요?
대부분의 사람은 아직 못 씁니다.
- 지금: "신뢰할 수 있는 테스터" 대상 연구 미리보기입니다.
- 곧: Google AI Ultra 구독자는 Project Genie에서, Gemini API와 Google AI Studio의 초기 접근 파트너는 각 서비스에서 쓰게 됩니다. 테크크런치는 "앞으로 몇 주 안에"라고 전했고, DeepMind 글에는 "곧"이라고만 적혀 있습니다.
- 대기자 명단: Project Genie 안에 Genie 4 대기자 명단이 열려 있습니다.
- 가격, 이용 지역, 정확한 날짜: 현재 확인된 공식 자료에는 없습니다.
참고로 Project Genie는 2026년 1월 29일 Genie 3 기반 실험용 프로토타입으로 시작했습니다. 처음에는 미국의 만 18세 이상 Google AI Ultra 구독자만 쓸 수 있었고 생성 길이는 60초로 제한됐습니다. 이후 Google은 자격이 되는 Ultra 구독자에게 전 세계로 차츰 넓힌다고 밝혔습니다. Genie 4에도 같은 제한이 적용될지는 알려지지 않았습니다.
아직 남은 한계
DeepMind는 Genie 4를 초기 단계의 실험적 모델이라고 부르며 한계를 직접 적었습니다. 크게 세 가지로 묶을 수 있습니다.
- 시간이 지나면 흔들립니다. 한 번에 오래 돌리거나, 문장 수정을 여러 번 하거나, 장면 안을 많이 돌아다니면 세부 모습과 물체의 일관성이 처음과 달라질 수 있습니다. 한 번에 이어 갈 수 있는 시간도 몇 분 수준입니다.
- 정확도가 아직 모자랍니다. 실제 장소를 완벽하게 재현하지 못하고, 화면 속 글자는 입력한 설명에 그 글자가 들어 있을 때 읽을 만하게 나오는 경우가 많습니다. 실시간 소리와 복잡한 물리 반응의 정확도도 연구 과제로 남아 있습니다.
- 여럿이 얽히면 어렵습니다. 사용자와 여러 독립된 인물이 한 공간에서 서로 영향을 주고받는 상황은 아직 제대로 다루지 못합니다.
공식 모델 페이지의 데모에는 설명 목적이며 일부 구간을 줄여 보여 준다는 안내가 붙어 있습니다. 테크크런치는 기자회견에서 DeepMind 측이 최종 제품이 어떤 모습일지 아직 분명하지 않다고 말했다고 전합니다. 안전 장치로는 미리보기 시작 전 내부 안전 평가를 거쳤고, Genie 4가 만든 영상과 소리에 SynthID 워터마크를 넣는다고 밝혔습니다.
자주 묻는 질문
Q. 게임을 만들 수 있나요? 개발자들이 아이디어를 탐험 가능한 시제품으로 빠르게 시험하는 용도로 테스트 중입니다. 제가 확인한 공식 자료는 '아이디어를 시제품으로 시험하는 용도'까지만 설명합니다.
Q. 영상 생성 AI인 Veo와 뭐가 다른가요? DeepMind 사이트는 Veo를 소리가 있는 영화 같은 영상을 만드는 모델로 소개합니다. Genie는 내 조작과 글 입력에 따라 다음 장면이 실시간으로 바뀐다는 점이 핵심입니다.
Q. AI가 만든 장면인지 알 수 있나요? Genie 4가 만든 영상과 소리에는 SynthID라는 워터마크가 들어갑니다. 눈과 귀로는 느끼기 어려운 방식이라고 하며, 일반 사용자가 직접 확인하는 방법은 발표문에 나오지 않았습니다.
마무리
DeepMind가 내세우는 변화는 네 가지입니다. 말 대신 글로 장면을 바꾸는 실시간 조종, 더 사실적인 물리와 인물 표현, 세계와 함께 만들어지는 소리와 대사, 그리고 장면의 앞뒤를 맞추고 흐름을 이끄는 Gemini 모델과의 결합입니다. 확인되지 않은 것도 분명합니다. 해상도, 프레임 수, 가격, 지역, 정확한 출시일은 현재 확인된 공식 자료에는 없습니다. 데모 영상만 보고 기대치를 정하기보다 직접 써 볼 수 있게 된 뒤에 확인하는 편이 낫겠습니다. 새 공식 정보가 나오면 내용이 달라질 수 있으니 아래 원문도 함께 확인해 보세요.
참고 자료
- Genie 4: A new generation of world simulation (Google DeepMind, 2026-10-27)
- We're announcing Genie 4 (Google 블로그, 2026-10-27)
- Genie 4 모델 페이지 (Google DeepMind)
- Genie 3: A new frontier for world models (Google DeepMind, 2025-08-05)
- Genie 2: A large-scale foundation world model (Google DeepMind, 2024-12-04)
- Project Genie 소개 (Google 블로그, 2026-01-29)
- Simulate real-world places with Project Genie and Street View (Google 블로그)
- Google's Genie 4 world model adds audio, more realistic worlds, and real-time steering (TechCrunch, 2026-10-27)